Очень часто маркетолог ищет ответы на вопросы типа: «Увеличится ли показатель рыночной доли при увеличении числа дилеров?», «Есть ли связь между объемом сбыта и рекламой?» Такие связи не всегда имеют причинно-следственный характер, а могут иметь просто статистическую природу. В поставленных вопросах можно определенно говорить о влиянии одного фактора на другой. Однако степень влияния изучаемых факторов может быть различной; скорее всего, влияние могут оказывать также какие-то другие факторы. Выделяют четыре типа связей между двумя переменными: немонотонная, монотонная, линейная и криволинейная.
Немонотонная связь характеризуется тем, что присутствие (отсутствие) одной переменной систематически связано с присутствием (отсутствием) другой переменной, но ничего неизвестно о направлении этого взаимодействия (приводит ли, например, увеличение одной переменной к увеличению или уменьшению другой). Например, известно, что посетители закусочных в утренние часы предпочитают заказывать кофе, а в середине дня - чай.
Немонотонная связь просто показывает, что утренние посетители предпочитают также заказывать яйца, бутерброды и бисквиты, а в обеденное время скорее заказывают мясные блюда с гарниром.
Монотонная связь характеризуется возможностью указать только общее направление связи между двумя переменными без использования каких-либо количественных характеристик. Нельзя сказать, насколько, например, определенное увеличение одной переменной приводит к увеличению другой переменной. Существуют только два типа таких связей: увеличение и уменьшение. Например, владельцу обувного магазина известно, что более взрослые дети обычно требуют обувь бoльших размеров. Однако невозможно четко установить связь между конкретным возрастом и точным размером обуви.
Линейная связь характеризует прямолинейную зависимость между двумя переменными. Знание количественной характеристики одной переменной автоматически предопределяет знание величины другой переменной:
у=а+bх, (4.3)
где у - оцениваемая или прогнозируемая зависимая переменная (результативный признак);
а - свободный член уравнения;
b - коэффициент регрессии, измеряющий среднее отношение отклонения результативного признака от его средней величины к отклонению факторного признака от его средней величины на одну единицу его измерения - вариация у, приходящаяся на единицу вариации х;
х - независимая переменная (факторный признак), используемая для определения зависимой переменной.
Коэффициенты а и b рассчитываются на основе наблюдений величин у и х с помощью метода наименьших квадратов .
Предположим, что торговый агент продает детские игрушки, посещая квартиры случайным образом. Отсутствие посещения какой-то квартиры означает отсутствие продажи, или а = 0. Если в среднем каждый десятый визит сопровождается продажей на 62 доллара, то стоимость продажи на один визит составит 6,2 доллара, или b = 6,2.
у=0 + 6,2х.
Таким образом, можно ожидать, что при 100 визитах доход составит 620 долларов. Надо помнить, что эта оценка не является обязательной, а носит вероятностный характер.
Криволинейная связь характеризует связь между переменными, носящую более сложный характер по сравнению с прямой линией. Например, связь между переменными может описываться 5-образной кривой (см. раздел 7.3).
В зависимости от своего типа связь может быть охарактеризована путем определения: ее присутствия (отсутствия), направления и силы (тесноты) связи.
Присутствие характеризует наличие или отсутствие систематической связи между двумя изучаемыми переменными; оно имеет статистическую природу. Проведя испытание статистической значимости, определяют, существует ли зависимость между данными. Если результаты исследования отвергают нулевую гипотезу, это говорит о том, что зависимость между данными существует.
В случае монотонных линейных связей последние могут быть описаны с точки зрения их направления - в сторону увеличения или уменьшения.
Связь между двумя переменными может быть сильной, умеренной, слабой или отсутствовать. Сильная зависимость характеризуется высокой вероятностью существования связи между двумя переменными, слабая - малой вероятностью.
Существуют специальные процедуры для определения указанных выше характеристик связей. Первоначально надо решить, какой тип связей может существовать между двумя изучаемыми переменными. Ответ на этот вопрос зависит от выбранной шкалы измерений.
Шкала низкого уровня (наименований) может отразить только неточные связи, в то время как шкала отношений, или интервальная, - очень точные связи. Определив тип связи (монотонная, немонотонная), надо установить, существует ли эта связь для генеральной совокупности в целом. Для этого проводятся статистические испытания.
После того как найдено, что для генеральной совокупности существует определенный тип связи, устанавливается ее направление. Наконец, необходимо установить силу (тесноту) связи.
Для определения, существует или нет немонотонная зависимость, используется таблица сопряженности двух переменных и критерий хи-квадрат. Как правило, критерий хи-квадрат применяется для анализа таблиц сопряженности номинальных признаков, однако он может использоваться и при анализе взаимосвязи порядковых, или интервальных, переменных. Если, скажем, было выяснено, что две переменные не связаны друг с другом, то их дальнейшим исследованием заниматься не стоит. Некоторые указания на связь скорее были обусловлены ошибкой выборки. Если же тест на хи-квадрат указал на связь, то она существует в реальности для генеральной совокупности и ее, возможно, следует изучать. Однако этот анализ не указывает на характер связи.
Предположим, что изучалась лояльность к определенной марке пива среди служащих и рабочих (двумя переменными, измеренными в шкале наименований). Результаты опроса затабулированы в следующем виде (табл. 4.16).
Таблица 4.16
Матрицы сопряженности частоты
Результаты первоначальной табуляции
Первоначальные процентные данные (деление на 200)

Проценты по колонкам

Первая из приведенных матриц содержит наблюдаемые частоты, которые сравниваются с ожидаемыми частотами, определяемыми как теоретические частоты, вытекающие из принимаемой гипотезы об отсутствии связи между двумя переменными (выполняется нулевая гипотеза). Величина отличия наблюдаемых частот от ожидаемых выражается с помощью величины х-квадрата. Последняя сравнивается с ее табличным значением для выбранного уровня значимости. Когда величина хи-квадрата мала, то нулевая гипотеза принимается, а следовательно, считается, что две переменные являются независимыми и исследователю не стоит тратить время на выяснение связи между ними, поскольку связь является результатом выборочной ошибки.
Вернемся к нашему примеру и рассчитаем ожидаемые частоты, пользуясь таблицей частот:
 =

где f ni - наблюдаемая частота в ячейке i;
f ai - ожидаемая частота в ячейке i;
n - число ячеек матрицы.
Из таблицы критических значений х-квадрата вытекает, что для степени свободы, равной в нашем примере 1, и уровня значимости альфа =0,05 критическое значение х-квадрата равно 3,841 . Видно, что расчетное значение х-квадрата существенно больше его критического значения. Это говорит о существовании статистически значимой связи между родом деятельности и лояльностью к исследованной марке пива, и не только для данной выборки, но и для совокупности в целом. Из таблицы следует, что главная связь заключается в том, что рабочие покупают пиво данной марки реже по сравнению со служащими.
Теснота связи и ее направление определяются путем расчета коэффициента корреляции, который изменяется от -1 до +1. Абсолютная величина коэффициента корреляции характеризует тесноту связи, а знак указывает на ее направление .
Вначале определяется статистическая значимость коэффициента корреляции. Безотносительно к его абсолютной величине коэффициент корреляции, не обладающий статистической значимостью, бессмыслен. Статистическая значимость проверяется с помощью нулевой гипотезы, которая констатирует, что для совокупности коэффициент корреляции равен нулю. Если нулевая гипотеза отвергается, это означает, что коэффициент корреляции для выборки является значимым и его значение для совокупности не будет равно нулю. Существуют таблицы, с помощью которых, для выборки определенного объема, можно определить наименьшую величину значимости для коэффициента корреляции.
Таблица 4.17
Сила связи в зависимости от величины коэффициента корреляции
Рассмотрим пример. Исследуется возможная взаимосвязь между суммарными продажами компании на отдельных двадцати территориях и числом сбытовиков, осуществляющих эти продажи. Были рассчитаны средние величины продаж и средние квадратические отклонения. Средняя величина продаж составила 200 миллионов долларов, а среднее квадратическое отклонение - 50 миллионов долларов. Среднее число сбытовиков равнялось 12 при среднем квадратическом отклонении, равном 4. Для стандартизации полученных чисел в целях проведения унифицированных сравнений объемы продаж в каждом регионе переводятся в величины средних квадратических отклонений от средней величины для всех регионов (путем вычитания объема продаж для каждого региона из среднего для регионов объема продаж и деления полученных величин на среднее квадратическое отклонение). Такие же расчеты проводятся и для сбытовиков, обслуживающих разные регионы (рис. 4.7). Из рис. 4.7 видно, что две линии изменяются подобным образом. Это говорит о положительной, очень тесной связи двух исследуемых переменных.

Рис. 4.7. Корреляция между числом сбытовиков и объемами продаж
Исходные данные в рассматриваемом примере также возможно представить по-другому (рис. 4.8). Из рис. 4.8 вытекают относительно слабый разброс точек (если бы все они легли на одну линию, коэффициент корреляции был бы равен +1) и достаточно большой угол наклона воображаемой кривой, проведенной через эти точки, что говорит о сильном влиянии численности сбытовиков на объем продаж.
Зависимая переменная не чувствительна к изменениям независимой.
Монотонно возрастающая зависимость: увеличению значений независимой переменной соответствует изменение зависимой переменной.
Монотонно убывающая зависимость: увеличению значений независимой переменной соответствует уменьшение уровня зависимой переменной.
Аналитическая форма зависимости между изучаемой парой
признаков (регрессионная функция) определяется с помощью
следующих методов:
1) на основе визуальной оценки характера связи. На линей$
ном графике по оси абсцисс откладываются значения фактор$
ного (независимого) признака x, по оси ординат - значения
результативного признака y. На пересечении соответствую$
щих значений отмечаются точки. Полученный точечный гра$
фик в указанной системе координат называется корреляцион$
ным полем. При соединении полученных точек получается
эмпирическая линия, по виду которой можно судить не только
о наличии, но и о форме зависимости между изучаемыми пе$
ременными;
3.Экономические модели и типы статистических данных, используемых в них
К наиболее распространённым эконометрическим моделям относятся:
модели потребительского и сберегательного потребления;
модели взаимосвязи риска и доходности ценных бумаг;
модели предложения труда;
макроэкономические модели (модель роста);
модели инвестиций;
маркетинговые модели;
модели валютных курсов и валютных кризисов и др.
Статистические и математические модели экономических явлений и процессов определяются спецификой той или иной области экономических исследований. Так, в экономике качества модели, на которых основаны статистические методы сертификации и управления качеством - модели статистического приемочного контроля, статистического контроля (статистического регулирования) технологических процессов (обычно с помощью контрольных карт Шухарта или кумулятивных контрольных карт), планирования экспериментов, оценки и контроля надежности и другие - используют как технические, так и экономические характеристики, а потому относятся к эконометрике, равно как и многие модели теории массового обслуживания (теории очередей). Экономический эффект только от использования статистического контроля в промышленности США оценивается как 0,8 % валового национального продукта (20 миллиардов долларов в год), что существенно больше, чем от любого иного экономико-математического или эконометрического метода.
Каждой области экономических исследований, связанной с анализом эмпирических данных, как правило, соответствуют свои эконометрические модели. Например, для моделирования процессов налогообложения с целью оценки результатов применения управляющих воздействий (например, изменения ставок налогов) на процессы налогообложения должен быть разработан комплекс соответствующих эконометрических моделей. Кроме системы уравнений, описывающей динамику системы налогообложения под влиянием общей экономической ситуации, управляющих воздействий и случайных отклонений, необходим блок экспертных оценок. Полезен блок статистического контроля, включающий как методы выборочного контроля правильности уплаты налогов (налогового аудита), так и блок выявления резких отклонений параметров, описывающих работу налоговых служб. Подходам к проблеме математического моделирования процессов налогообложения посвящена монография , содержащая также информацию о современных статистических (эконометрических) методах и экономико-математических моделях, в том числе имитационных.
С помощью эконометрических методов следует оценивать различные величины и зависимости, используемые при построении имитационных моделей процессов налогообложения, в частности, функции распределения предприятий по различным параметрам налоговой базы. При анализе потоков платежей необходимо использовать эконометрические модели инфляционных процессов, поскольку без оценки индекса инфляции невозможно вычислить дисконт-функцию, а потому нельзя установить реальное соотношение авансовых и «итоговых» платежей.
Прогнозирование сбора налогов может осуществляться с помощью системы временных рядов - на первом этапе по каждому одномерному параметру отдельно, а затем - с помощью некоторой линейной эконометрической системы уравнений, дающей возможность прогнозировать векторный параметр с учетом связей между координатами и лагов, то есть влияния значений переменных в определенные прошлые моменты времени. Возможно, более полезными окажутся имитационные модели более общего вида, основанные на интенсивном использовании современной вычислительной техники.
4. Основные этапы эконометрического моделирования
Выделяют семь основных этапов эконометрического моделирования:
1) постановочный этап, в процессе осуществления которого определяются конечные цели и задачи исследования, а также совокупность включённых в модель факторных и результативных экономических переменных. При этом включение в эконометрическую модель той или иной переменной должно быть теоретически обоснованно и не должно быть слишком большим. Между факторными переменными не должно быть функциональной или тесной корреляционной связи, потому что это приводит к наличию в модели мультиколлинеарности и негативно сказывается на результатах всего процесса моделирования;
2) априорный этап, в процессе осуществления которого проводится теоретический анализ сущности исследуемого процесса, а также формирование и формализация известной до начала моделирования (априорной) информации и исходных допущений, касающихся в частности природы исходных статистических данных и случайных остаточных составляющих в виде ряда гипотез;
3) этап параметризации (моделирования), в процессе осуществления которого выбирается общий вид модели и определяется состав и формы входящих в неё связей, т. е. происходит непосредственно моделирование.
К основным задачам этапа параметризации относятся:
а) выбор наиболее оптимальной функции зависимости результативной переменной от факторных переменных. При возникновении ситуации выбора между нелинейной и линейной функциями зависимости, предпочтение всегда отдаётся линейной функции, как наиболее простой и надёжной;
б) задача спецификации модели, в которую входят такие подзадачи, как аппроксимация математической формой выявленных связей и соотношений между переменными, определение результативных и факторных переменных, формулировка исходных предпосылок и ограничений модели.
4) информационный этап, в процессе осуществления которого происходит сбор необходимых статистических данных, а также анализируется качество собранной информации;
5) этап идентификации модели, в ходе осуществления которого происходит статистический анализ модели и оцененивание неизвестных параметров. Данный этап непосредственно связан с проблемой идентифицируемостимодели, т. е. ответа на вопрос «Возможно ли восстановить значения неизвестных параметров модели по имеющимся исходным данным в соответствии с решением, принятым на этапе параметризацииβ». После положительного ответа на этот вопрос решается проблема идентификации модели, т. е. реализуется математически корректная процедура оценивания неизвестных параметров модели по имеющимся исходным данным;
6) этап оценки качества модели, в ходе осуществления которого проверяется достоверность и адекватность модели, т. е. определяется, насколько успешно решены задачи спецификации и идентификации модели, какова точность расчётов, полученных на её основе. Построенная модель
должна быть адекватна реальному экономическому процессу. Если качество модели является неудовлетворительным, то происходит возврат ко второму этапу моделирования;
7) этап интерпретации результатов моделирования.
№5 Эконометрический анализ производственного процесса
Рассматривая эконометрическое исследование в целом, в нем можно выделить следующие этапы:
1. Постановка проблемы, т. е. определение цели и задач исследования, выделение зависимых (уj) и независимых (xk) экономических переменных на основе качественного анализа изучаемых взаимосвязей методами экономической
2. Сбор необходимых исходных данных.
3. Построение эконометрической модели и оценка ее адекватности и степени соответствия исходным данным.
4. Использование модели для целей анализа и прогнозирования параметров исследуемого явления.
5. Качественная и количественная интерпретация полученных на основе модели результатов.
6. Практическое использование результатов. В процессе экономической интерпретации результатов необходимо ответить на следующие вопросы: 12
– являются ли статистически значимыми объясняющие факторы, важные с теоретической точки зрения?
– соответствуют ли оценки параметров модели качественным представлениям?
№6. Парный регрессионный анализ
Регрессией в теории вероятностей и математической статистике принято называть зависимость среднего значения какой-либо величины (y) от некоторой другой величины или от нескольких величин (хi).
Парной регрессией называется модель, выражающая зависимость среднего значения зависимой переменной y от одной независимой переменной х
где у – зависимая переменная (результативный признак); х – независимая,
объясняющая переменная (признак–фактор).
Парная регрессия применяется, если имеется доминирующий фактор, обуславливающий большую долю изменения изучаемой объясняемой переменной, который и используется в качестве объясняющей переменной.
Множественной регрессией называют модель, выражающую зависимость среднего значения зависимой переменной y от нескольких независимых переменных х1, х2, …, хp
ŷ = f (x1,x2,...,xp).
Классическая нормальная модель линейной множественной регрессии.
По виду аналитической зависимости различают линейные и нелинейные регрессии.
Линейная парная регрессия описывается уравнением: ŷ=a+bx
Если между экономическими явлениями существуют нелинейные соотношения, то они выражаются с помощью соответствующих нелинейных функций: например, равносторонней гиперболы , параболы второй степени и д.р.
№7. . Линейная парная регрессия. Определение параметров уравнения регрессии
Линейная парная регрессия описывается уравнением: ŷ=a+bx, согласно которому изменение Δy переменной y прямопропорционально изменению Δx переменной x (Δy = b·Δx). Для оценки параметров a и b уравнения регрессии (2.6) воспользуемся методом наименьших квадратов (МНК). При определенных предположениях относительно ошибки ε МНК дает наилучшие оценки параметров линейной
модели. Модель парной линейной регрессии : y = a +b*x +u (y- зависимая переменная, a +b*x – неслучайная составляющая, х – независимая переменная, u- случайная составляющая)
1 | | | | | | | |
Основные положения совпадают с требованиями к билету №43,увеличится лишь размерность таблицы и надо после раскрытия основных положений, сходных с билетом 43, -перечислить основные методики анализа связи между несколькими переменными- а именно- метод хи квадрат(билет 45), регрессионный анализ, корреляционный анализ, кластерный, анализ, сетевой анализ, факторный анализ.
45.Статистика хи-квадрат (х 2)
Статистический анализ полученных с помощью массового опроса данных, как и анализ наблюдений изучаемого явления или статистических данных, включает несколько уровней сложности и возможностей получения дополнительной (скрытой) информации. В социальных и политических исследованиях результат наблюдений, подтверждающий справедливость выдвинутой гипотезы, крайне редко выступает основанием для ее принятия как истинной, поскольку он может также сочетаться и с рядом других объяснительных гипотез.
Тест хи-квадрат используется для двухвходовых таблиц сопряженности. Схема проведения:
1. Строится таблица сопряженности
2. Затем формулируют нулевую и альтернативную гипотезы. Нулевая гипотеза (H f) - утверждение, отрицающее зависимость между радами переменных. Альтернативная гипотеза (HJ - гипотеза о наличии связи между признаками.
3. Заполняется альтернатиная таблица по формуле: произведение соответствующих маргинальных частот (значения строки и столбца) делят на общее число респондентов
4. Вычесление величины x-квадрат по формуле
Х 2 =Σ х (n-n 1) 2 /n 1
Уровень х-квадрат определяет вероятность отклонения исследуемого показателя.
46. Корреляционный анализ
Основные понятия корреляционного анализа
Выделяют несколько видов связи между переменными: Корреляционная зависимостьпредполагает взаимную согласованность изменений переменных величин, а также то, что эти изменения можно измерить однократно или многократно.
Функциональное воздействие предполагает, что изменения независимой переменной сопровождаются все более ускоряющимися изменениями зависимой переменной. Функциональная зависимость - связь переменных, означающая, что изменение одной переменной оказывает воздействие на изменение другой, которая в свою очередь воздействует на первую переменную.
Корреляция - наличие статистической взаимосвязи признаков, когда каждому определенному значению одного признака X соответствует определенное значение У.
Корреляционный анализ выясняет функциональную зависимость между переменными величинами, которая характеризуется тем, что каждому значению одной из них соответствует вполне опреде- тенпое значение другой.
Различают парную и множественную корреляции. Парная корреляция характеризует тип, форму и плотность связи между двумя признаками, множественная - между несколькими.
Корреляционная зависимость возникает чаще всего там, где одно явление находится под воздействием большого числа факторов, действующих с разной силой, поэтому существуют специальные меры корреляционной связи, называемые коэффициентами корреляции.
Корреляционный анализ последовательно решает три практические задачи:
1) определение корреляционного поля и составление корреляционной таблицы;
2) вычисление выборочных корреляционных отношений или коэффициентов корреляции;
3) проверка статистической гипотезы значимости связи.
Коэффициент корреляции не содержит информации о том, является ли данная связь между ними причинно-следственной или сопутствующей.
Для установления корреляционной связи между двумя признаками необходимо доказать, что все другие переменные не оказывают воздействия на отношения двух переменных, являющихся предметом изучения.
Регрессионный анализ.
Регрессионный анализ - один из методов многомерного статистического анализа данных, объединяющий совокупность статистических приемов, предназначенных для изучения или моделирования связей между одной зависимой и несколькими (или одной) независимыми переменными.
Множественный регрессионный анализ – это метод установления зависимости одной переменной от двух или более независимых переменных. В то время как зависимая переменная (та переменная, которую Вы хотите предсказать) должна быть непрерывной (за исключением логистической регрессии), независимые переменные могут быть как прерывными, так и категориальными, такими как «пол» или «тип применяемого препарата». В случае категориальных независимых переменных необходимо будет создавать переменные «пустышки», а не использовать соответствующие значения.
Процедура:
возможно выполнение в 2 вариантах:
· стандартном (когда одновременно учитываются все независимые переменные)
· пошаговом (прямом и обратном) вариантах.
С помощью прямого пошагового действия в регрессионном анализе последовательно включаются переменные - начиная с той, которая наиболее тесно коррелирует с зависимой переменной. Процедура продолжается, пока включение новых независимых переменных обеспечивает прирост коэффициента множественной корреляции, тем самым определяется оптимальный максимальный набор переменных. При использовании обратного пошагового метода машина последовательно отбрасывает независимые переменные, которые наиболее слабо коррелируют с зависимой переменной (т.е. обладают наименьшей объясняющей способностью), оставляя оптимальный минимум.
Современные статистические программы (например SPSS) позволяют рассчитывать не только различные варианты линейной регрессии, но и нелинейные регрессии. Однако при анализе данных, полученных с помощью опросов (и массовых, и экспертных), чаще всего используется модель линейной регрессии.
Теоретическая валидизация в социологическом исследовании: Методология и методы
Анализ парных связей
Описание взаимосвязей между явлениями и процессами - отдельная тема. Поэтому предлагаю поговорить о ней более подробно.

0 Нажми, если пригодилось =ъ
Согласно исследованию научных публикаций в наиболее престижных зарубежных журналах, посвященных социальным и поведенческим наукам (Ч.Теддли, М.Элайс, 2010), 77% всех социологических исследований проведены в рамках количественного подхода. Из них 71% является корреляционными исследованиями или исследованиями, посвященными изучению связей между социальными явлениями.
Самый простой вид корреляционных исследований - изучение парных взаимосвязей или совместной изменчивости двух переменных. Такого рода исследования пригодны для решения двух научных задач:
а) доказательства существования причинно-следственной связи между переменными (наличие связи является важным, но не единственным, условием причинно-следственной зависимости); б) предсказания: в случае наличия связи между переменными можно с определенным уровнем точности предсказывать значения одной переменной, если нам известно значение другой.
Связь между двумя переменными есть в том случае, когда изменение категории одной переменной ведет к изменению распределения второй:
Продуктивность труда |
Удовлетворенность работой |
|||
Продуктивность труда |
Удовлетворенность работой |
||
Легко заметить, что в зависимости от категории переменной "Удовлетворенность работой" переменная "Продуктивность труда" меняет свое распределение. Следовательно, мы можем сделать вывод о существовании связи между переменными.
Также из этого примера видно, что каждому из значений одной переменной отвечает несколько значений другой. Такие связи называются статистическими или вероятностными. В данном случае, связь между переменными не является абсолютной. В нашем случае это означает, что кроме удовлетворенности работой есть и другие факторы, влияющие на продуктивность труда.
В случае же, когда одному значению первой переменной соответствует лишь одно значение второй, говорят о функциональных связях. Вместе с тем, даже когда есть основания говорить о функциональной связи, невозможно на все 100% продемонстрировать ее в эмпирической действительности по двум причинам: а) из-за погрешности измерительных инструментов; б) из-за невозможности контроля всех условий окружающей среды, влияющих на эту связь. И поскольку в социальных науках ученые имеют дело именно с вероятностными связями, постольку ниже речь пойдет именно о них.
Парные связи владеют тремя характеристиками: силой, направлением и формой.
Сила
показывает насколько согласованна изменчивость двух переменных. Сила связи может изменяться в диапазоне от 0 до +1 (если хотя бы одна из переменных относится к номинальной шкале) или от -1 до +1 (если обе переменные относятся, по крайней мере, к порядковой шкале). При этом 0 и близкие к ней величины говорят об отсутствии связи между переменными, а величины близкие к +1 (прямая связь) или -1 (обратная связь) - о сильной связи. Один из вариантов интерпретации связи, с точки зрения ее силы, выглядит следующим образом:
Все значения в таблице приведены в модуле, т.е. должны анализироваться безотносительно к знаку. Так, например, связь -0,67 и +0,67 являются одинаковыми по силе, но разными по направлению.
Сила связи определяется с помощью коэффициентов корреляции. К коэффициентам корреляции относятся, например, фи и V-крамера (номинальные переменные, мало категорий/табличный вид), Гамма (порядковые переменные, мало категорий/табличный вид), Кендалла и Спирмена (порядковые переменные, много категорий), Пирсона (метрические переменные, много категорий).
Направление
говорит о характере взаимного изменения категорий переменных. Если с увеличением значений одной переменной значения другой переменной также увеличиваются, то связь является прямой (или положительной). Если же ситуация противоположная и увеличение значений одной переменной ведет к уменьшению значений второй, то связь обратная (или отрицательная).
Направление связи может иметь место только в тех случаях, когда речи идет о порядковых и/или метрических переменных, то есть тех переменных, значения которых можно упорядочить от меньших к большим или наоборот. Таким образом, если хотя бы одна переменная относится к номинальной шкале, то можно говорить только о силе связи и ее форме, но не о направлении.
Направление связи можно определить либо с помощью таблиц сопряженности (мало категорий), либо с помощью диаграммы рассеяния (много категорий), либо с помощью знака коэффициента корреляции (количество категорий переменных не имеет значения):
Пример положительной связи
2-я перем-я |
1-я перем-я |
||
Пример отрицательной связи
2-я перем-я |
1-я перем-я |
||
В данной диаграмме представлена взаимосвязь между количеством усилий, которые прикладывают студенты в процессе учебы (10-бальная порядковая шкала, ось Х), и успешностью их учебы в бакалаврате (среднее значение успешности сдачи сессий за 4 года обучения, ось Y). Поскольку нижний левый угол соответствует малым значениям обоих переменных, а верхний правый - большим, постольку диаграмма свидетельствует о положительной взаимосвязи между переменными. Думаю, вы представляете, как бы выглядела диаграмма рассеяния в случае отрицательной взаимосвязи.

В результате подсчета коэффициент корреляции равен либо положительному, либо отрицательному значению, что само по себе говорит о его направлении.
Несмотря на то, что значения коэффициента корреляции достаточно для получения основной информации про связь между переменными, его вычисление принято предварять построением таблицы или диаграммы рассеяния, которые необходимы для получения дополнительной информации, в частности - про форму связи.
Форма
связи указывает на особенности совместной изменчивости двух переменных. В зависимости от того, к какой шкале относится переменная, форму связи можно проанализировать либо с помощью столбчатой диаграммы/таблицы сопряженности (если хотя бы одна переменная является номинальной), либо с помощью диаграммы рассеяния (для порядковых и метрических шкал).
Обратимся к примеру. В одном из своих исследования, единицами анализа которого выступили две кафедры разных вузов, я установил, что сила связи между переменными равна 0,83 в обоих случаях (в качестве переменных выступили тип студента и успешность сдачи последней сессии). Таким образом, сила и направление связи были одинаковы для обоих вузов. В свою очередь форма связи показала важные отличия (нажмите на график для увеличения):

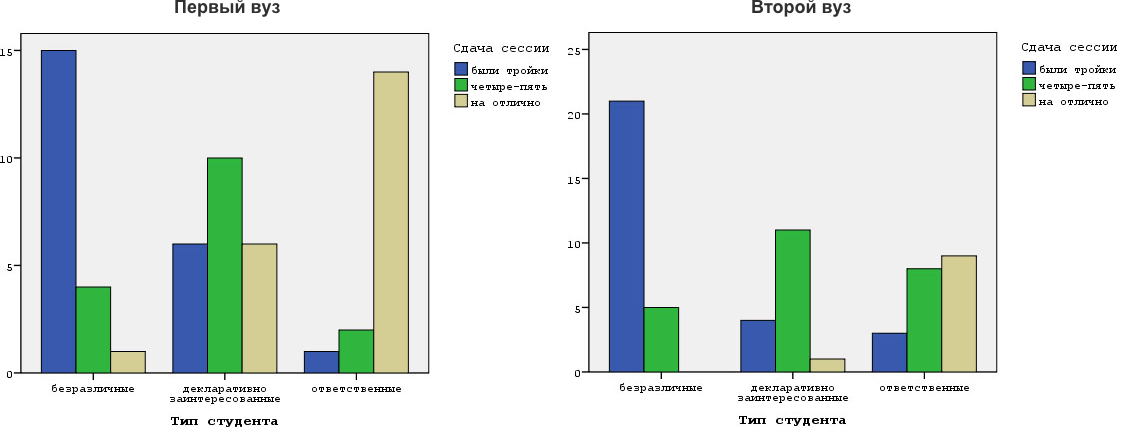
Различия в форме распределения очевидны. Судя по всему, на первой кафедре значительно легче учиться, чем на второй. На это, в частности, указывает количество студентов, сдавших сессию на отлично.
Диаграммы рассеяния дают более ценную в аналитическом смысле информацию - кроме сравнения различных единиц анализа, они позволяют оценить отклонение связи от линейности. Линейность является важным условием эффективного применения коэффициентов корреляции и многих других статистических методов. Она наблюдается в том случае, когда каждое новое увеличение значений одной из переменных на единицу ведет к увеличению значений другой переменной на одинаковую или приблизительно одинаковую величину. Так, для приведенной ранее диаграммы рассеяния, увеличение значения 10-бальной шкалы на единицу ведет к увеличению успешности студента на величину близкую к 0,2.
Когда связь между переменными достаточно близка к идеальной линейной модели, коэффициенты корреляции адекватно отображают силу связи и ее направление (в случае представленной ранее диаграммы рассеяния, сила связи равна 0,93). В противном случае (т.е. в случае нелинейных связей) необходимо использовать специальные методы анализа данных. Примером диаграммы, демонстрирующей криволинейную связь, может служить следующий:

Такая форма связи может быть, например, между тревожностью студента и успешностью сдачи экзамена, когда как чрезмерно низкая, так и чрезмерно высокая тревожность приводят к снижению успешности.
Подводя итог, хочется отметить один важный момент: анализ связи с точки зрения ее силы, направления и формы - это только первый шаг анализа парных связей. После того, как мы определили что взаимосвязь представляет научный или практический интерес, необходимо проверить ее на статистическую значимость, так как наличие связи в выборке еще не означает ее наличие в генеральной совокупности. Такого рода задачи решаются с помощью методов статистического вывода, специфика которых рассмотрена .
Анализ данных начинается с перевода «сырых» данных в осмысленную информации и включает их введение в компьютер, проверку на предмет ошибок, кодирование, представление в матричной форме (табулирование). Все это называется преобразованием исходных данных.
Далее проводится статистический анализ, т.е. определяются средние величины, частоты, корреляционные и регрессионные соотношения, осуществляется анализ трендов. После сбора данных необходимо их преобразовать, т.е. привести к более сжатому виду, удобному для анализа и обладающему достаточной для заказчика информацией. Обычно закодированные исходные данные представляются в виде матрицы, столбцы которой содержат ответы на различные вопросы анкеты, а ряды -- респондентов или изучаемые ситуации. Преобразование заключается в описании данных матрицы на языке ограниченного числа мер, характеризующих собранные данные. Табулирование помогает исследователю понять, что означают собранные данные. Одновременный анализ двух и более категорий опрашиваемых называется перекрестной табуляцией. Исследователь, осуществляя преобразование, старается найти зависимости среди собранных данных и в то же время достигнуть наиболее высокого уровня обобщения.
Выделяют, по крайней мере, следующие четыре функции преобразования данных: обобщение, определение концепции (концептуализация), перевод результатов статистического анализа на понятный для менеджера язык (коммуникация), определение степени соответствия полученных результатов всей совокупности (экстраполяция). Из-за неспособности человека анализировать большие массивы информации необходимо исходные собранные данные представить в удобном для осмысления виде, т.е. их необходимо обобщить, выразить через ограниченное число понятных параметров.
Большинство статистических мер основано на конкретных предположениях, которые определяют базу анализа собранных данных. Концептуализация направлена на оценку результатов обобщения. Например, слабый разброс оценок определенной марки продукта вырабатывает у исследователя одно суждение (концепцию), сильный -- другое.
Коммуникация предполагает при интерпретации полученных результатов использование понятных для заказчика категорий. Например, если для него понятна такая статистическая мера, как «мода», то она используется при представлении полученных результатов, если нет, то результаты описываются на общепринятом языке.
Экстраполяция в данном случае предполагает определение, в какой степени данные выборки можно обобщить на всю совокупность. Определение и интерпретация связей между двумя переменными В связях не всегда имеются причинно-следственный характер, а могут иметь просто статистическую природу. В поставленных вопросах можно определенно говорить о влиянии одного фактора на другой. Однако степень влияния изучаемых факторов может быть различной; скорее всего, влияние могут оказывать также какие-то другие факторы. Выделяют четыре типа связей между двумя переменными: немонотонная, монотонная, линейная и криволинейная.
Немонотонная связь характеризуется тем, что присутствие (отсутствие) одной переменной систематически связано с присутствием (отсутствием) другой переменной, но ничего неизвестно о направлении этого взаимодействия (приводит ли, например, увеличение одной переменной к увеличению или уменьшению другой). Например, известно, что посетители закусочных в утренние часы предпочитают заказывать кофе, а в середине дня -- чай.
Немонотонная связь просто показывает, что утренние посетители предпочитают также заказывать яйца, бутерброды и бисквиты, а в обеденное время скорее заказывают мясные блюда с гарниром.
Монотонная связь характеризуется возможностью указать только общее направление связи между двумя переменными без использования каких-либо количественных характеристик. Нельзя сказать, насколько, например, определенное увеличение одной переменной приводит к увеличению другой переменной.
Существуют только два типа таких связей: увеличение и уменьшение. Например, владельцу обувного магазина известно, что более взрослые дети обычно требуют обувь больших размеров. Однако невозможно четко установить связь между конкретным возрастом и точным размером обуви.
Линейная связь характеризует прямолинейную зависимость между двумя переменными. Знание количественной характеристики одной переменной автоматически предопределяет знание величины другой переменной:
Где у -- оцениваемая или прогнозируемая зависимая переменная (результативный признак); а -- свободный член уравнения; х -- независимая переменная (факторный признак), используемая для определения зависимой переменной. b -- коэффициент регрессии, измеряющий среднее отношение отклонения результативного признака от его средней величины к отклонению факторного признака от его средней величины на одну единицу его измерения -- вариация у, приходящаяся на единицу вариации х.
Коэффициенты а и b рассчитываются на основе наблюдений величин у и х с помощью метода наименьших квадратов.
Криволинейная связь характеризует связь между переменными, носящую более сложный характер по сравнению с прямой линией. Например, связь между переменными может описываться S-об разно и кривой.
В зависимости от своего типа связь может быть охарактеризована путем определения: ее присутствия (отсутствия), направления и силы (тесноты) связи. Присутствие характеризует наличие или отсутствие систематической связи между двумя изучаемыми переменными; оно имеет статистическую природу. Проведя испытание статистической значимости, определяют, существует ли зависимость между данными. Если результаты исследования отвергают нулевую гипотезу, это говорит о том, что зависимость между данными существует.
В случае монотонных линейных связей последние могут быть описаны с точки зрения их направления -- в сторону увеличения или уменьшения. Связь между двумя переменными может быть сильной, умеренной, слабой или отсутствовать. Сильная зависимость характеризуется высокой вероятностью существования связи между двумя переменными, слабая -- малой вероятностью.
Существуют специальные процедуры для определения указанных выше характеристик связей. Первоначально надо решить, какой тип связей может существовать между двумя изучаемыми переменными. Ответ на этот вопрос зависит от выбранной шкалы измерений.
Шкала низкого уровня (наименований) может отразить только неточные связи, в то время как шкала отношений, или интервальная, -- очень точные связи. Определив тип связи (монотонная, немонотонная), надо установить, существует ли эта связь для генеральной совокупности в целом. Для этого проводятся статистические испытания.
После того как найдено, что для генеральной совокупности существует определенный тип связи, устанавливается ее направление. Наконец, необходимо установить силу (тесноту) связи.
Наиболее распространенным способом социологического анализа является выявление взаимосвязи между переменными.
Термин переменная заимствован социологией из области математики и логики. Однако используется он в социологии в ином значении. Если в математике под переменной используется символ, вместо которого могут быть подставлены любые числа, то в социологии под переменной понимается то свойство или отношение исследуемых социальных явлений, которое может иметь большую или меньшую степень интенсивности и тем самым может быть редуцировано к числу. Так, свойство «возраст» может иметь множество значений. Свойство «биологический пол» имеет два значения
Понятие переменной относительно, так как зависит и от природы исследуемого свойства, допускающей тот или иной спектр дробления, и от принятой системы измерения.
Для переменных в социологии существует определенная классификация, использование которой значительно облегчает задачи выравнивания условий функционирования экспериментальной и контрольных групп и последующий контроль за ними в ходе эксперимента.
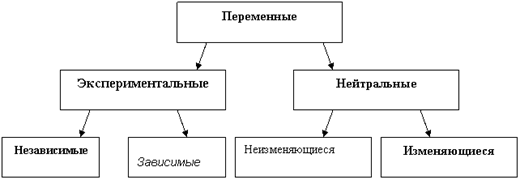
В процессе исследования следует различать Экспериментальные и Не экспериментальные Переменные. Экспериментальные переменные в свою очередь, делятся на Зависимые И Независимые переменные.
Независимую переменную можно рассматривать как причину (фактор), а зависимую как следствие (результат) воздействия независимой переменной.
Неэкспериментальные Переменные отражают те свойства и отношения исследуемого объекта, которые в равной степени действуют и в экспериментальной и в контрольной группах. Поэтому их называют Нейтральными.
Среди нейтральных переменных выделяются Неизменяющиеся и изменяющиеся переменные. К первым относятся те характеристики объекта, о которых известно, что в течение всего периода исследования они останутся без изменения. Следовательно, они требуют меньшего контроля. Ко вторым - те переменные, изменения которых возможны, и часто трудно прогнозируемы. Основное внимание (в отношении контроля) должно быть уделено этим переменным. Типологию переменных Г. А.Андреева представила в следующей схеме:
Связь различных переменных специфику и механизм функционирования исследуемого объекта. Социолог прослеживает, как изменяются одни переменные с изменением других. Если увеличение, например, такой независимой переменной как возраст ведет к увеличению производительности труда (зависимая переменная), то можно прийти к выводу о положительной (прямой) зависимости между переменными. Обратная зависимость (большеи меньше) свидетельствует об отрицательной связи.
Однако существует опасность прийти к ложному выводу, если не учитываетсяСкрытая переменная - незамеченная причина (обстоятельство), влияющее на исследуемое свойство. Так, у женщин, или у молодых рабочих могут оказаться низкие показатели в труде, что может дать повод к выводу об определяющей роли пола и возраста в труде. В то же время могут оказаться незамеченными исследователем такие скрытые независимые переменные, как квалификация и опыт.
Макс Вебер обнаружил у англичан - протестантов более высокую степень предпринимательской активности чем у англичан - католиков. Отсюда он пришел к выводу об определяющей роли протестантской этики в развитии капитализма. Однако он не учитывал такую Скрытую Переменную, как отстранение в XVIII веке протестантов от государственной деятельности, что способствовало ориентации их активности на другие сферы, в том числе и предпринимательскую.
социологический исследование выборка
-