Рассмотрим Распределение ХИ-квадрат. С помощью функции MS EXCEL ХИ2.РАСП() построим графики функции распределения и плотности вероятности, поясним применение этого распределения для целей математической статистики.
Распределение ХИ-квадрат (Х 2 , ХИ2, англ. Chi - squared distribution ) применяется в различных методах математической статистики:
- при построении ;
- при ;
- при (согласуются ли эмпирические данные с нашим предположением о теоретической функции распределения или нет, англ. Goodness-of-fit)
- при (используется для определения связи между двумя категориальными переменными, англ. Chi-square test of association).
Определение : Если x 1 , x 2 , …, x n независимые случайные величины, распределенные по N(0;1), то распределение случайной величины Y=x 1 2 + x 2 2 +…+ x n 2 имеет распределение Х 2 с n степенями свободы.
Распределение Х 2 зависит от одного параметра, который называется степенью свободы (df , degrees of freedom ). Например, при построении число степеней свободы равно df=n-1, где n – размер выборки .
Плотность распределения
Х 2
выражается формулой:
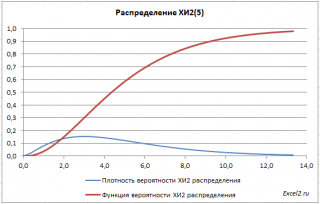
Графики функций
Распределение Х 2 имеет несимметричную форму, равно n, равна 2n.
В файле примера на листе График приведены графики плотности распределения вероятности и интегральной функции распределения .
Полезное свойство ХИ2-распределения
Пусть x 1 , x 2 , …, x n независимые случайные величины, распределенные по нормальному закону
с одинаковыми параметрами μ и σ, а X cр
является арифметическим средним
этих величин x.
Тогда случайная величина y
равная
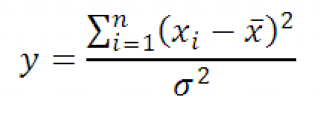
Имеет Х 2 -распределение с n-1 степенью свободы. Используя определение вышеуказанное выражение можно переписать следующим образом:
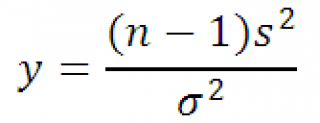
Следовательно, выборочное распределение статистики y, при выборке из нормального распределения , имеет Х 2 -распределение с n-1 степенью свободы.
Это свойство нам потребуется при . Т.к. дисперсия может быть только положительным числом, а Х 2 -распределение используется для его оценки, то y д.б. >0, как и указано в определении.
ХИ2-распределение в MS EXCEL
В MS EXCEL, начиная с версии 2010, для Х 2 -распределения имеется специальная функция ХИ2.РАСП() , английское название – CHISQ.DIST(), которая позволяет вычислить плотность вероятности (см. формулу выше) и (вероятность, что случайная величина Х, имеющая ХИ2 -распределение , примет значение меньше или равное х, P{X <= x}).
Примечание : Т.к. ХИ2-распределение является частным случаем , то формула =ГАММА.РАСП(x;n/2;2;ИСТИНА) для целого положительного n возвращает тот же результат, что и формула =ХИ2.РАСП(x;n; ИСТИНА) или =1-ХИ2.РАСП.ПХ(x;n) . А формула =ГАММА.РАСП(x;n/2;2;ЛОЖЬ) возвращает тот же результат, что и формула =ХИ2.РАСП(x;n; ЛОЖЬ) , т.е. плотность вероятности ХИ2-распределения.
Функция ХИ2.РАСП.ПХ()
возвращает функцию распределения
, точнее - правостороннюю вероятность, т.е. P{X > x}. Очевидно, что справедливо равенство
=ХИ2.РАСП.ПХ(x;n)+ ХИ2.РАСП(x;n;ИСТИНА)=1
т.к. первое слагаемое вычисляет вероятность P{X > x}, а второе P{X <= x}.
До MS EXCEL 2010 в EXCEL была только функция ХИ2РАСП() , которая позволяет вычислить правостороннюю вероятность, т.е. P{X > x}. Возможности новых функций MS EXCEL 2010 ХИ2.РАСП() и ХИ2.РАСП.ПХ() перекрывают возможности этой функции. Функция ХИ2РАСП() оставлена в MS EXCEL 2010 для совместимости.
ХИ2.РАСП() является единственной функцией, которая возвращает плотность вероятности ХИ2-распределения (третий аргумент должен быть равным ЛОЖЬ). Остальные функции возвращают интегральную функцию распределения , т.е. вероятность того, что случайная величина примет значение из указанного диапазона: P{X <= x}.
Вышеуказанные функции MS EXCEL приведены в .
Примеры
Найдем вероятность, что случайная величина Х примет значение меньше или равное заданного x : P{X <= x}. Это можно сделать несколькими функциями:
ХИ2.РАСП(x; n; ИСТИНА)
=1-ХИ2.РАСП.ПХ(x; n)
=1-ХИ2РАСП(x; n)
Функция ХИ2.РАСП.ПХ() возвращает вероятность P{X > x}, так называемую правостороннюю вероятность, поэтому, чтобы найти P{X <= x}, необходимо вычесть ее результат от 1.
Найдем вероятность, что случайная величина Х примет значение больше заданного x : P{X > x}. Это можно сделать несколькими функциями:
1-ХИ2.РАСП(x; n; ИСТИНА)
=ХИ2.РАСП.ПХ(x; n)
=ХИ2РАСП(x; n)
Обратная функция ХИ2-распределения
Обратная функция используется для вычисления альфа - , т.е. для вычисления значений x при заданной вероятности альфа , причем х должен удовлетворять выражению P{X <= x}=альфа .
Функция ХИ2.ОБР() используется для вычисления доверительных интервалов дисперсии нормального распределения .
Функция ХИ2.ОБР.ПХ() используется для вычисления , т.е. если в качестве аргумента функции указан уровень значимости, например 0,05, то функция вернет такое значение случайной величины х, для которого P{X>x}=0,05. В качестве сравнения: функция ХИ2.ОБР() вернет такое значение случайной величины х, для которого P{X<=x}=0,05.
В MS EXCEL 2007 и ранее вместо ХИ2.ОБР.ПХ() использовалась функция ХИ2ОБР() .
Вышеуказанные функции можно взаимозаменять, т.к. следующие формулы возвращают один и тот же результат:
=ХИ.ОБР(альфа;n)
=ХИ2.ОБР.ПХ(1-альфа;n)
=ХИ2ОБР(1- альфа;n)
Некоторые примеры расчетов приведены в файле примера на листе Функции .
Функции MS EXCEL, использующие ХИ2-распределение
Ниже приведено соответствие русских и английских названий функций:
ХИ2.РАСП.ПХ()
- англ. название CHISQ.DIST.RT, т.е. CHI-SQuared DISTribution Right Tail, the right-tailed Chi-square(d) distribution
ХИ2.ОБР()
- англ. название CHISQ.INV, т.е. CHI-SQuared distribution INVerse
ХИ2.ПХ.ОБР()
- англ. название CHISQ.INV.RT, т.е. CHI-SQuared distribution INVerse Right Tail
ХИ2РАСП()
- англ. название CHIDIST, функция эквивалентна CHISQ.DIST.RT
ХИ2ОБР()
- англ. название CHIINV, т.е. CHI-SQuared distribution INVerse
Оценка параметров распределения
Т.к. обычно ХИ2-распределение используется для целей математической статистики (вычисление доверительных интервалов, проверки гипотез и др.), и практически никогда для построения моделей реальных величин, то для этого распределения обсуждение оценки параметров распределения здесь не производится.
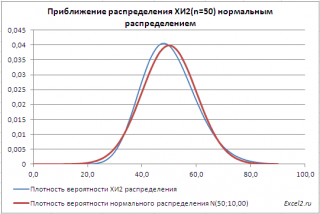
Приближение ХИ2-распределения нормальным распределением
При числе степеней свободы n>30 распределение Х 2
хорошо аппроксимируется нормальным распределением
со средним значением
μ=n и дисперсией σ
=2*n (см. файл примера лист Приближение
).
Министерство образования и науки Российской Федерации
Федеральное агентство по образованию города Иркутска
Байкальский государственный университет экономики и права
Кафедра Информатики и Кибернетики
Распределение "хи-квадрат" и его применение
Колмыкова Анна Андреевна
студентка 2 курса
группы ИС-09-1
Для обработки полученных данных используем критерий хи-квадрат.
Для этого построим таблицу распределения эмпирических частот, т.е. тех частот, которые мы наблюдаем:
Теоретически, мы ожидаем, что частоты распределятся равновероятно, т.е. частота распределится пропорционально между мальчиками и девочками. Построим таблицу теоретических частот. Для этого умножим сумму по строке на сумму по столбцу и разделим получившееся число на общую сумму (s).
Итоговая таблица для вычислений будет выглядеть так:
χ2 = ∑(Э - Т)² / Т
n = (R - 1), где R – количество строк в таблице.
В нашем случае хи-квадрат = 4,21; n = 2.
По таблице критических значений критерия находим: при n = 2 и уровне ошибки 0,05 критическое значение χ2 = 5,99.
Полученное значение меньше критического, а значит принимается нулевая гипотеза.
Вывод: учителя не придают значение полу ребенка при написании ему характеристики.
Приложение
Критические точки распределения χ2
Таблица 1

Заключение
Студенты почти всех специальностей изучают в конце курса высшей математики раздел "теория вероятностей и математическая статистика", реально они знакомятся лишь с некоторыми основными понятиями и результатами, которых явно не достаточно для практической работы. С некоторыми математическими методами исследования студенты встречаются в специальных курсах (например, таких, как "Прогнозирование и технико-экономическое планирование", "Технико-экономический анализ", "Контроль качества продукции", "Маркетинг", "Контроллинг", "Математические методы прогнозирования", "Статистика" и др. – в случае студентов экономических специальностей), однако изложение в большинстве случаев носит весьма сокращенный и рецептурный характер. В результате знаний у специалистов по прикладной статистике недостаточно.
Поэтому большое значение имеет курс "Прикладная статистика" в технических вузах, а в экономических вузах – курса "Эконометрика", поскольку эконометрика – это, как известно, статистический анализ конкретных экономических данных.
Теория вероятности и математическая статистика дают фундаментальные знания для прикладной статистики и эконометрики.
Они необходимы специалистам для практической работы.
Я рассмотрела непрерывную вероятностную модель и постаралась на примерах показать ее используемость.
Список используемой литературы
1. Орлов А.И. Прикладная статистика. М.: Издательство "Экзамен", 2004.
2. Гмурман В.Е. Теория вероятностей и математическая статистика. М.: Высшая школа, 1999. – 479с.
3. Айвозян С.А. Теория вероятностей и прикладная статистика, т.1. М.: Юнити, 2001. – 656с.
4. Хамитов Г.П., Ведерникова Т.И. Вероятности и статистика. Иркутск: БГУЭП, 2006 – 272с.
5. Ежова Л.Н. Эконометрика. Иркутск: БГУЭП, 2002. – 314с.
6. Мостеллер Ф. Пятьдесят занимательных вероятностных задач с решениями. М. : Наука, 1975. – 111с.
7. Мостеллер Ф. Вероятность. М. : Мир, 1969. – 428с.
8. Яглом А.М. Вероятность и информация. М. : Наука, 1973. – 511с.
9. Чистяков В.П. Курс теории вероятностей. М.: Наука, 1982. – 256с.
10. Кремер Н.Ш. Теория вероятностей и математическая статистика. М.: ЮНИТИ, 2000. – 543с.
11. Математическая энциклопедия, т.1. М.: Советская энциклопедия, 1976. – 655с.
12. http://psystat.at.ua/ - Статистика в психологии и педагогике. Статья Критерий Хи-квадрат.
|
Достоинством критерия Пирсона является его универсальность: с его помощью можно проверять гипотезы о различных законах распределения.
1. Проверка гипотезы о нормальном распределении.
Пусть получена выборка достаточно большого объема п с большим количеством различных значений вариант. Для удобства ее обработки разделим интервал от наименьшего до наибольшего из значений вариант на s равных частей и будем считать, что значения вариант, попавших в каждый интервал, приближенно равны числу, задающему середину интервала. Подсчитав число вариант, попавших в каждый интервал, составим так называемую сгруппированную выборку:
варианты………..х 1 х 2 … х s
частоты………….п 1 п 2 … п s ,
где х i – значения середин интервалов, а п i – число вариант, попавших в i -й интервал (эмпирические частоты).
По полученным данным можно вычислить выборочное среднее и выборочное среднее квадратическое отклонение σ В . Проверим предположение, что генеральная совокупность распределена по нормальному закону с параметрами M (X ) = , D (X ) = . Тогда можно найти количество чисел из выборки объема п , которое должно оказаться в каждом интервале при этом предположении (то есть теоретические частоты). Для этого по таблице значений функции Лапласа найдем вероятность попадания в i -й интервал:
 ,
где а i и b i - границы i -го интервала. Умножив полученные вероятности на объем выборки п, найдем теоретические частоты: п i =n·p i .Наша цель – сравнить эмпирические и теоретические частоты, которые, конечно, отличаются друг от друга, и выяснить, являются ли эти различия несущественными, не опровергающими гипотезу о нормальном распределении исследуемой случайной величины, или они настолько велики, что противоречат этой гипотезе. Для этого используется критерий в виде случайной величины
 . (20.1)
Смысл ее очевиден: суммируются части, которые квадраты отклонений эмпирических частот от теоретических составляют от соответствующих теоретических частот. Можно доказать, что вне зависимости от реального закона распределения генеральной совокупности закон распределения случайной величины (20.1) при стремится к закону распределения (см. лекцию 12) с числом степеней свободы k = s – 1 – r , где r – число параметров предполагаемого распределения, оцененных по данным выборки. Нормальное распределение характеризуется двумя параметрами, поэтому k = s – 3. Для выбранного критерия строится правосторонняя критическая область, определяемая условием
 (20.2)
где α
– уровень значимости. Следовательно, критическая область задается неравенством  а область принятия гипотезы - .
Итак, для проверки нулевой гипотезы Н 0: генеральная совокупность распределена нормально – нужно вычислить по выборке наблюдаемое значение критерия:
 , (20.1`)
а по таблице критических точек распределения χ 2 найти критическую точку , используя известные значения α и k = s – 3. Если - нулевую гипотезу принимают, при ее отвергают.
2. Проверка гипотезы о равномерном распределении.
При использовании критерия Пирсона для проверки гипотезы о равномерном распределении генеральной совокупности с предполагаемой плотностью вероятности

необходимо, вычислив по имеющейся выборке значение , оценить параметры а и b по формулам:
где а*
и b*
- оценки а
и b
. Действительно, для равномерного распределения М
(Х
) = ,  , откуда можно получить систему для определения а*
и b
*: , решением которой являются выражения (20.3).
Затем, предполагая, что  , можно найти теоретические частоты по формулам

Здесь s – число интервалов, на которые разбита выборка.
Наблюдаемое значение критерия Пирсона вычисляется по формуле (20.1`), а критическое – по таблице с учетом того, что число степеней свободы k = s – 3. После этого границы критической области определяются так же, как и для проверки гипотезы о нормальном распределении.
3. Проверка гипотезы о показательном распределении.
В этом случае, разбив имеющуюся выборку на равные по длине интервалы, рассмотрим последовательность вариант , равноотстоящих друг от друга (считаем, что все варианты, попавшие в i – й интервал, принимают значение, совпадающее с его серединой), и соответствующих им частот n i (число вариант выборки, попавших в i – й интервал). Вычислим по этим данным и примем в качестве оценки параметра λ величину . Тогда теоретические частоты вычисляются по формуле
Затем сравниваются наблюдаемое и критическое значение критерия Пирсона с учетом того, что число степеней свободы k = s – 2.
Описание критерия
Назначения критерия
Критерий «хи-квадрат» Пирсона
Материалы лекции
Тема 6. Выявление различий в распределении признака
Критерий Пирсона: назначение критерия, его описание, область применения, алгоритм расчета.
Критерий Колмогорова–Смирнова для сравнения результатов количественного измерения: назначение критерия, его описание, область применения, алгоритм расчета.
При изучении данной темы необходимо учесть то, что оба критерия непараметрические, они оперируют частотами. Обратите особое внимание на правила принятия решения для рассмотренных критериев: эти правила могут быть противоположны. Внимательно изучите ограничения в применении критериев.
После изучения материала лекции ответьте на контрольные вопросы, ответы занесите в конспект.
Критерий «хи-квадрат» Пирсона может решать несколько задач, в том числе и сравнение распределений.
Критерий χ 2 применяется в двух целях;
1) для сопоставления эмпирического распределения признака с теоретическим - равномерным, нормальным или каким-то иным;
2) для сопоставления двух, трех или более эмпирических распределений одного и того же признака, то есть для проверки их однородности;
3) для оценки стохастической (вероятностной) независимости в системе случайных событий и т.д.
Критерий χ 2 отвечает на вопрос о том, с одинаковой ли частотой встречаются разные значения признака в эмпирическом и теоретическом распределениях или в двух и более эмпирических распределениях.
Преимущество метода состоит в том, что он позволяет сопоставлять распределения признаков, представленных в любой шкале, начиная от шкалы наименований. В самом простом случае альтернативного распределения ("да - нет", "допустил брак - не допустил брака", "решил задачу - не решил задачу" и т. п.) мы уже можем применить критерий χ 2 .
1. Объем выборки должен быть достаточно большим: N>30. При N<30 критерий χ 2 дает весьма приближенные значения. Точность критерия повышается при больших N.
2. Теоретическая частота для каждой ячейки таблицы не должна быть меньше 5: f ≥ 5. Это означает, что если число разрядов задано заранее и не может быть изменено, то мы не можем применять метод χ 2 , не накопив определенного минимального числа наблюдений. Если, например, мы хотим проверить наши предположения о том, что частота обращений в телефонную службу Доверия неравномерно распределяются по 7 дням недели, то нам потребуется 5-7=35 обращений. Таким образом, если количество разрядов (k) задано заранее, как в данном случае, минимальное число наблюдений (N min) определяется по формуле: .
3. Выбранные разряды должны "вычерпывать" все распределение, то есть охватывать весь диапазон вариативности признаков. При этом группировка на разряды должна быть одинаковой во всех сопоставляемых распределениях.
4. Необходимо вносить "поправку на непрерывность" при сопоставлении распределений признаков, которые принимают всего 2 значения. При внесении поправки значение χ 2 , уменьшается (см. пример с поправкой на непрерывность).
5. Разряды должны быть неперекрещивающимися: если наблюдение отнесено к одному разряду, то оно уже не может быть отнесено ни к какому другому разряду. Сумма наблюдений по разрядам всегда должна быть равна общему количеству наблюдений.
Алгоритм расчета критерия χ 2
1. Составить таблицу взаимной сопряженности значений признаков следующего вида (по сути это двумерный вариационный ряд, в котором указываются частоты появления совместных значений признака) - таблица 19. В таблице располагаются условные частоты, которые мы обозначим в общем виде как f ij . Например, число градаций признака х равно 3 (k=3), число градаций признака у равно 4 (m=4); тогда i меняется от 1 до k, а j меняется от 1 до m.
Таблица 19
| х i у j | х 1 | х 2 | х 3 | ∑ |
| у 1 | f 11 | f 21 | f 31 | f –1 |
| у 2 | f 12 | f 22 | f 32 | f –2 |
| у 3 | f 13 | f 23 | f 33 | f –3 |
| у 4 | f 14 | f 24 | f 34 | f –4 |
| ∑ | f 1– | f 2– | f 3– | N |
2. Далее для удобства расчетов преобразуем исходную таблицу взаимной сопряженности в таблицу следующего вида (таблица 20), располагая столбики с условными частотами один под другим: Занести в таблицу наименования разрядов (столбцы 1 и 2) и соответствующие им эмпирические частоты (3-й столбец).
Таблица 20
| х i | у j | f ij | f ij * | f ij – f ij * | (f ij – f ij *) 2 | (f ij – f ij *) 2 / f ij * |
| 1 | 2 | 3 | 4 | 5 | 6 | 7 |
| х 1 | у 1 | f 11 | f 11 * | |||
| х 1 | у 2 | f 12 | f 12 * | |||
| х 1 | у 3 | f 13 | f 13 * | |||
| х 1 | у 4 | f 14 | f 14 * | |||
| х 2 | у 1 | f 21 | f 21 * | |||
| х 2 | у 2 | f 22 | f 22 * | |||
| х 2 | у 3 | f 23 | f 23 * | |||
| х 2 | у 4 | f 24 | f 24 * | |||
| х 3 | у 1 | f 31 | f 31 * | |||
| х 3 | у 2 | f 32 | f 32 * | |||
| х 3 | у 3 | f 33 | f 33 * | |||
| х 3 | у 4 | f 34 | f 34 * | |||
| ∑=…………. |
3. Рядом с каждой эмпирической частотой записать теоретическую частоту (4-й столбец), которая вычисляется по следующей формуле (итоговая частоты по соответствующей строчке умножается на итоговую частоту по соответствующему столбику и делится на общее количество наблюдений):

5. Определить число степеней свободы по формуле: ν=(k-1)(m-1) , где k - количество разрядов признака х , m - количество разрядов признака у .
Если ν=1, внести поправку на "непрерывность" и записать её в столбце 5а.
Поправка на непрерывность состоит в том, что от разности между условной и теоретической частотой отнимается еще 0,5. Тогда заголовки столбиков в нашей таблице будет выглядеть следующим образом (таблица 21):
Таблица 21
| х | у | f ij | f ij * | f ij – f ij * | f ij – f ij * – 0,5 | (f ij – f ij * – 0,5) 2 | (f ij – f ij * – 0,5) 2 / f ij * |
| 1 | 2 | 3 | 4 | 5 | 5а | 6 | 7 |
6. Возвести в квадрат полученные разности и занести их в 6-й столбец.
7. Разделить полученные квадраты разностей на теоретическую частоту и записать результаты в 7-й столбец.
8. Просуммировать значения 7-го столбца. Полученную сумму обозначить как χ 2 эмп.
9. Правило принятия решения:
Расчетное значение критерия необходимо сравнить с критическим (или табличным) значением. Критическое значение находится в зависимости от числа степеней свободы по таблице критических значений критерия χ 2 Пирсона (см. Приложение 1.6).
Если χ 2 расч ≥ χ 2 табл, то расхождения между распределениями статистически достоверны, или признаки изменяются согласованно, или связь между признаками статистически значима.
Если χ 2 расч < χ 2 табл, то расхождения между распределениями статистически недостоверны, или признаки изменяются несогласованно, или связи между признаками нет.
). Конкретная формулировка проверяемой гипотезы от случая к случаю будет варьировать.
В этом сообщении я опишу принцип работы критерия \(\chi^2\) на (гипотетическом) примере из иммунологии . Представим, что мы выполнили эксперимент по установлению эффективности подавления развития микробного заболевания при введении в организм соответствующих антител . Всего в эксперименте было задействовано 111 мышей, которых мы разделили на две группы, включающие 57 и 54 животных соответственно. Первой группе мышей сделали инъекции патогенных бактерий с последующим введением сыворотки крови, содержащей антитела против этих бактерий. Животные из второй группы служили контролем – им сделали только бактериальные инъекции. После некоторого времени инкубации оказалось, что 38 мышей погибли, а 73 выжили. Из погибших 13 принадлежали первой группе, а 25 – ко второй (контрольной). Проверяемую в этом эксперименте нулевую гипотезу можно сформулировать так: введение сыворотки с антителами не оказывает никакого влияния на выживаемость мышей. Иными словами, мы утверждаем, что наблюдаемые различия в выживаемости мышей (77.2% в первой группе против 53.7% во второй группе) совершенно случайны и не связаны с действием антител.
Полученные в эксперименте данные можно представить в виде таблицы:
Всего |
|||
Бактерии + сыворотка |
|||
Только бактерии |
|||
Всего |
Таблицы, подобные приведенной, называют таблицами сопряженности . В рассматриваемом примере таблица имеет размерность 2х2: есть два класса объектов («Бактерии + сыворотка» и «Только бактерии»), которые исследуются по двум признакам ("Погибло" и "Выжило"). Это простейший случай таблицы сопряженности: безусловно, и количество исследуемых классов, и количество признаков может быть бóльшим.
Для проверки сформулированной выше нулевой гипотезы нам необходимо знать, какова была бы ситуация, если бы антитела действительно не оказывали никакого действия на выживаемость мышей. Другими словами, нужно рассчитать ожидаемые частоты для соответствующих ячеек таблицы сопряженности. Как это сделать? В эксперименте всего погибло 38 мышей, что составляет 34.2% от общего числа задействованных животных. Если введение антител не влияет на выживаемость мышей, в обеих экспериментальных группах должен наблюдаться одинаковый процент смертности, а именно 34.2%. Рассчитав, сколько составляет 34.2% от 57 и 54, получим 19.5 и 18.5. Это и есть ожидаемые величины смертности в наших экспериментальных группах. Аналогичным образом рассчитываются и ожидаемые величины выживаемости: поскольку всего выжили 73 мыши, или 65.8% от общего их числа, то ожидаемые частоты выживаемости составят 37.5 и 35.5. Составим новую таблицу сопряженности, теперь уже с ожидаемыми частотами:
Погибшие |
Выжившие |
Всего |
|
Бактерии + сыворотка |
|||
Только бактерии |
|||
Всего |
Как видим, ожидаемые частоты довольно сильно отличаются от наблюдаемых, т.е. введение антител, похоже, все-таки оказывает влияние на выживаемость мышей, зараженных патогенным микроорганизмом. Это впечатление мы можем выразить количественно при помощи критерия согласия Пирсона \(\chi^2\):
\[\chi^2 = \sum_{}\frac{(f_o - f_e)^2}{f_e},\]
где \(f_o\) и \(f_e\) - наблюдаемые и ожидаемые частоты соответственно. Суммирование производится по всем ячейкам таблицы. Так, для рассматриваемого примера имеем
\[\chi^2 = (13 – 19.5)^2/19.5 + (44 – 37.5)^2/37.5 + (25 – 18.5)^2/18.5 + (29 – 35.5)^2/35.5 = \]
Достаточно ли велико полученное значение \(\chi^2\), чтобы отклонить нулевую гипотезу? Для ответа на этот вопрос необходимо найти соответствующее критическое значение критерия. Число степеней свободы для \(\chi^2\) рассчитывается как \(df = (R - 1)(C - 1)\), где \(R\) и \(C\) - количество строк и столбцов в таблице сопряженности. В нашем случае \(df = (2 -1)(2 - 1) = 1\). Зная число степеней свободы, мы теперь легко можем узнать критическое значение \(\chi^2\) при помощи стандартной R-функции qchisq() :
Таким образом, при одной степени свободы только в 5% случаев величина критерия \(\chi^2\) превышает 3.841. Полученное нами значение 6.79 значительно превышает это критического значение, что дает нам право отвергнуть нулевую гипотезу об отсутствии связи между введением антител и выживаемостью зараженных мышей. Отвергая эту гипотезу, мы рискуем ошибиться с вероятностью менее 5%.
Следует отметить, что приведенная выше формула для критерия \(\chi^2\) дает несколько завышенные значения при работе с таблицами сопряженности размером 2х2. Причина заключается в том, что распределение самого критерия \(\chi^2\) является непрерывным, тогда как частоты бинарных признаков ("погибло" / "выжило") по определению дискретны. В связи с этим при расчете критерия принято вводить т.н. поправку на непрерывность , или поправку Йетса :
\[\chi^2_Y = \sum_{}\frac{(|f_o - f_e| - 0.5)^2}{f_e}.\]
"s Chi-squared test with Yates" continuity correction data : mice X-squared = 5.7923 , df = 1 , p-value = 0.0161
Как видим, R автоматически применяет поправку Йетса на непрерывность (Pearson"s Chi-squared test with Yates" continuity correction ). Рассчитанное программой значение \(\chi^2\) составило 5.79213. Мы можем отклонить нулевую гипотезу об отсутствии эффекта антител, рискуя ошибиться с вероятностью чуть более 1% (p-value = 0.0161 ). -